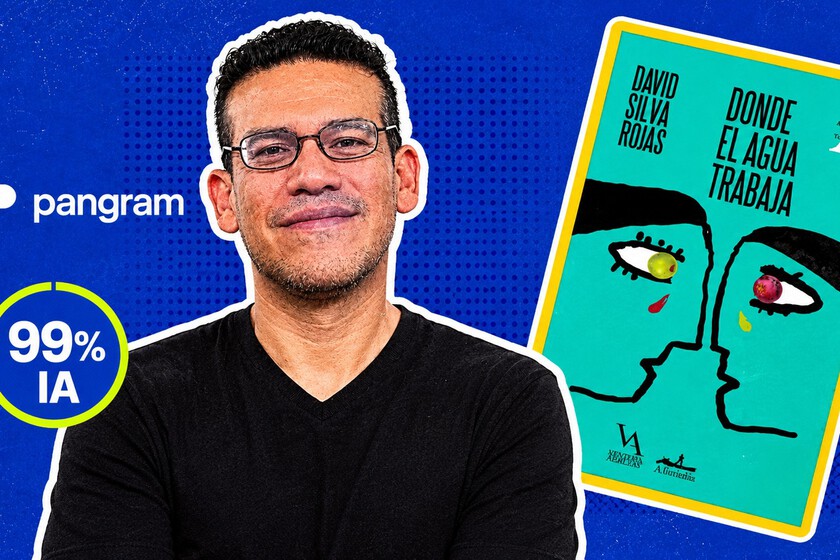
El detector de IA Pangram ha generado controversia al atribuir un 99% de inteligencia artificial a una novela ganadora de un premio literario, cuyas bases prohibían su uso. Este incidente ha puesto en el centro del debate la fiabilidad de estas herramientas para determinar la autoría, especialmente cuando sus veredictos pueden tener graves implicaciones para la reputación de los autores y el panorama editorial. La situación plantea interrogantes sobre la neutralidad y precisión de Pangram como juez de facto en el ámbito literario.
El pasado 23 de octubre, El País informó que el sistema de detección Pangram asignó un 99% de autoría a una inteligencia artificial a la obra ‘Donde el agua trabaja’, novela que obtuvo un premio cuyas normativas explícitamente vetaban el uso de esta tecnología. El autor ha desmentido rotundamente estas acusaciones, lo que ha llevado a la editorial a suspender las presentaciones del libro mientras se investiga el caso. De manera similar a 'C'était ça ou mourir' ('Era eso o morir') de Thélyson Orélien, la novela de David Silva Roja aborda temas de explotación, sufrimiento y memoria. Fue seleccionada entre 2.204 manuscritos provenientes de 22 países, destacando por su “sutileza en la escritura y el uso magistral de los silencios como recurso compositivo”.
A pesar de la polémica, la obra ha recibido los 20.000 euros correspondientes al Premio Internacional de Novela Breve Almadía–Ventosa Arrufat y actualmente se encuentra en proceso de traducción. Sin embargo, varias de sus presentaciones han sido canceladas. No es el objetivo de este análisis determinar si la novela fue o no creada con IA, dado lo complejo de la valoración. La cuestión central es otra: en un lapso breve, el software de una compañía privada ha asumido el rol de juez principal en la autoría literaria. ¿Es Pangram el árbitro que realmente necesitamos?
Pangram es un clasificador basado en redes neuronales, entrenado con textos de origen humano y otros generados por modelos de IA, e incorpora técnicas para minimizar los falsos positivos. Su funcionamiento consiste en analizar fragmentos de texto y proporcionar un porcentaje, que representa una estimación de cuán similar es el texto a lo que produciría una máquina, no una explicación de su proceso de creación. Según la propia empresa, Pangram 4 es capaz de detectar el 99,66% del texto generado por IA y comete un error en el 0,0041% del texto humano, lo que equivale a un fallo por cada 24.000 documentos. Esta afirmación no es exclusiva de la compañía: un estudio de la Universidad de Chicago lo posicionó por encima de GPTZero y Originality.ai, y El País corroboró que arrojaba un 0% en libros publicados antes de la aparición de ChatGPT. En el caso del Premio Goncourt, se confirmó posteriormente que el autor había utilizado IA.
La versión empleada por El País, Pangram 4.1, fue lanzada el 19 de octubre, cuatro días antes de la publicación del análisis. En un conjunto de 29.103 pares de textos con modificaciones mínimas, la frecuencia de cambios de veredicto no deseados se redujo del 1,08% al 0,15%, un problema similar al detectado en experimentos donde se añadía una coma o un espacio extra. Además, el sistema ofrece la probabilidad de cada categoría (humano, asistido por IA o generado por IA) y muestra menor certeza en textos con menos de 150 palabras.
La empresa reporta una tasa de falsos positivos del 0,009% en inglés y del 0,0026% en español, pero estas cifras se basan en texto web, no en novelas. Los falsos negativos aumentan ligeramente, del 0,34% al 0,37%. La propia descripción del producto reconoce que su tasa de error no es nula y que un simple error puede tener consecuencias perjudiciales para la reputación.
La revista Nature ha documentado que, cuando una inteligencia artificial modifica significativamente ensayos escritos por humanos, Pangram los clasifica como humanos el 41% de las veces. Engañar al sistema no resulta complicado: Jot Down también demostró cómo la adición de un espacio puede alterar el veredicto. Un estudio preliminar reciente sugiere que, después de pasar por un “humanizador”, los falsos negativos superan el 96%, lo que contrasta drásticamente con lo que la empresa anuncia (una detección del 98,83% frente a 13 humanizadores). La inconsistencia entre los diferentes estudios es notable.
Existe un límite más sutil. El CEO de la empresa explica que la tasa de falsos positivos se calcula utilizando millones de textos anteriores a 2022. Es razonable suponer que, desde entonces, muchos escritores han aprendido a integrar la IA en sus textos y a disimular su uso de manera más efectiva. En general, este sistema puede ser un buen filtro para principiantes, pero no indica cómo puntuará a quienes escriban en 2026, después de años de leer y corregir con modelos de IA. Además, un porcentaje no revela quién hizo qué: si la IA redactó, corrigió o solo sugirió tramas. Como ya se ha mencionado, el error no es simétrico: un falso positivo puede arruinar una reputación, mientras que un falso negativo no tiene coste alguno.
Pangram Labs, una empresa fundada por dos colegas de Brooklyn, ve crecer su negocio gracias a la desconfianza: según The Decoder, citando al New York Times, sus ingresos se multiplicaron por 35 en un año, y sus usuarios mensuales pasaron de 2.700 a 120.000 entre junio de 2025 y junio de 2026. Las tasas de error más frecuentemente citadas son las que ellos mismos proporcionan. A medida que su “intervalo de confianza” disminuye, su éxito parece aumentar. No obstante, como señaló Tim Requarth, en la actualidad ninguno de sus modelos es capaz de comprender las múltiples capas por las que atraviesa un texto real.
El estudio de Chicago es independiente (financiado por la universidad y un programa de Google Cloud, no por Pangram), pero GPTZero afirma que, con el mismo conjunto de pruebas, ahora supera a Pangram. No existe un estándar unificado: cada proveedor selecciona sus propias métricas, umbrales y corpus. Tampoco hay un protocolo establecido. El caso Goncourt se inició con una cuenta anónima en X que analizó fragmentos con Pangram. La Academia instó a la prudencia y a verificar la fiabilidad del software. Hoy en día, cualquiera puede iniciar un caso sin un umbral definido ni derecho a réplica, en medio del ruido de la “maldita IA”.
¿Qué ocurriría si se llega a juicio? Actualmente, no hay sentencias en España que establezcan el valor probatorio de estos detectores. En el proceso penal, la admisibilidad de las pruebas depende de su pertinencia, y el juez valora libremente. Un informe de Pangram tendría que presentarse como un dictamen pericial, con un experto capaz de explicar la metodología, el margen de error y someterse a un contrainterrogatorio.
Solo en este punto, ya se presentan tres problemas. El sistema es una caja negra neuronal que no explica por qué clasifica una frase de cierta manera; la tasa de error es declarada por el fabricante; y sus modelos están en constante cambio (Pangram 3, por ejemplo, tenía fecha de retirada el 30 de septiembre), lo que dificulta reproducir un veredicto meses después. Lo más probable es que estos informes sirvan como indicio para solicitar borradores, pero no como prueba de cargo por sí solos.
Si se necesita un juez para determinar la autoría de IA, este debería ser fiable, estar auditado, tener validez legal y ser neutral. Pangram es, con diferencia, el detector mejor valorado hoy en día. Sin embargo, está lejos de ser infalible. Sus auditorías se sitúan en el ámbito académico, no están respaldadas por una auditoría pública y recurrente con acceso al modelo. Ninguna normativa reconoce su validez legal, y existe un conflicto de intereses dado que es la propia empresa la que defiende su herramienta.
Europa avanza en otra dirección. El artículo 50 de la Ley de IA obliga a los proveedores de IA generativa a marcar sus resultados en un formato legible por máquina (con un plazo hasta el 2 de diciembre de 2026 para los sistemas ya existentes en el mercado), y la Comisión publicó el 10 de junio un código de buenas prácticas. No obstante, una marca de agua por sí sola no prueba nada y no cubre textos de modelos abiertos ni reescritos. Se necesita un auditor independiente, público y europeo que evalúe estos detectores con pruebas abiertas y comparables. Lo que tenemos actualmente dista mucho de cumplir con estos requisitos.