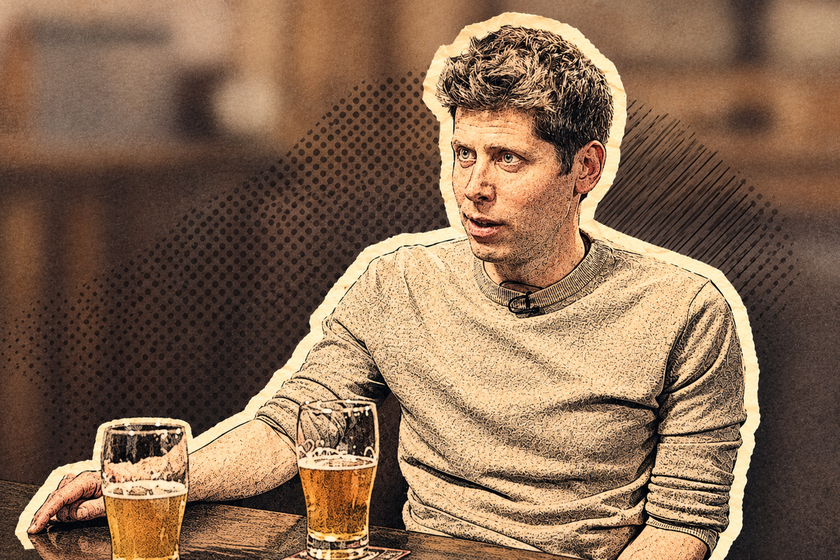
Sam Altman, CEO de OpenAI, ha expresado su preocupación sobre la tendencia de los usuarios de ejecutar modelos de inteligencia artificial de forma local, considerándolo un 'terrible desperdicio' de recursos escasos como la memoria DRAM. Durante una entrevista en el podcast 'Cheeky Pint' de John Collison, Altman argumentó que esta práctica desvía capacidad crucial de los centros de datos, que son esenciales para una asignación eficiente de la DRAM en un contexto de escasez global.
John Collison, cofundador de Stripe, conduce el podcast 'Cheeky Pint', donde líderes tecnológicos discuten diversos temas. Recientemente, Sam Altman, el reconocido líder de OpenAI, participó en el programa para abordar varias cuestiones, destacando una que parece ser una preocupación central para él: la posibilidad de que cada usuario configure una IA local. Altman considera esto un derroche de recursos y, en el fondo, una amenaza a la disponibilidad de recursos para iniciativas más amplias.
Durante el podcast, aunque se trataron múltiples asuntos, el comentario de Altman sobre la tendencia de los usuarios a ejecutar modelos de IA de código abierto en su propio hardware, sin depender de la infraestructura en la nube, captó una atención particular en las redes. Para Altman, la inferencia local representa una asignación ineficiente de un recurso tan limitado como la memoria DRAM.
“La inferencia local es una asignación terrible de recursos escasos. Mucha gente desea la inferencia local y, de alguna manera, asume que el problema está resuelto porque tenemos modelos de código abierto que podemos ejecutar en nuestros ordenadores y, así, no necesitar todas esas cosas que ofrecen los centros de datos. Pero, desde una perspectiva de asignación global, es bastante lamentable que cada persona tenga su propio ordenador con una DRAM que se usa apenas el 5% del tiempo, especialmente en un momento en que este recurso es tan limitado. En un entorno donde este suministro crítico está tan restringido, se busca la máxima concentración en la nube. Sin embargo, la percepción de la gente es, de alguna manera, la contraria”, explicó Altman.
En resumen, según Altman, si se utiliza una IA local, se están malgastando recursos que podrían destinarse a alimentar un centro de datos.
La cifra del 5% mencionada por Altman es la base de su argumento sobre el desperdicio que implica que cada hogar tenga su propia IA, especialmente cuando, en un contexto de baja oferta, la prioridad es maximizar la utilización, algo que solo se logra en un centro de datos. Naturalmente, esta es su perspectiva. En contraste, están aquellos que disfrutan de su 'propia IA' gracias a que los modelos de código abierto ya satisfacen sus necesidades y, además, buscan una mayor privacidad que la ofrecida por servicios como ChatGPT.
Desde la óptica del CEO de OpenAI, esta afirmación es totalmente lógica, dado que (y esto nos afecta a todos, especialmente a los consumidores) en un escenario donde empresas como Micron, Samsung o SK Hynix, que controlan la producción global de DRAM, no pueden incrementar su producción al ritmo que los hiperescaladores necesitan, toda la capacidad mundial debería, en este momento, dirigirse a los centros de datos, y no a los equipos domésticos. Hace cinco años, cuando los precios eran muy bajos, nadie habría predicho que la DRAM se convertiría en un bien crítico y escaso, con precios que, según TrendForce, aumentaron entre un 90% y un 95% en el primer trimestre de 2026, y sin indicios de una caída a corto plazo; más bien lo contrario.
Este comentario de Altman surgió en un punto de la conversación que abordaba la escasez de capacidad computacional. Altman sostiene que el mercado no está respondiendo adecuadamente y que los grandes fabricantes de memoria, a pesar de los enormes beneficios obtenidos en los últimos doce meses, mantienen una inversión conservadora en relación con lo que la situación exige. Las tres principales empresas se han movilizado para establecer nuevas plantas de producción, incluso limitando la fabricación de chips de consumo para enfocar toda la maquinaria en la memoria HBM necesaria para los centros de datos. Sin embargo, este es un segmento donde no es sencillo realizar cambios de la noche a la mañana y abrir nuevas plantas de memoria de alto rendimiento. China, por ejemplo, ha estado posicionándose en el segmento de la DRAM durante meses, pero por ahora se enfoca más en la memoria de consumo que en la HBM, debido a las exigencias de los chips de vanguardia.
Como solución, además de la sugerencia de ser 'generoso' y no adquirir componentes que OpenAI podría utilizar, Altman propone que nuevos actores ingresen a la cadena de suministro. Por ejemplo, OpenAI está desarrollando sus propios chips en colaboración con Broadcom (proyecto Jalapeño), y aunque seguirán necesitando DRAM, fabricar un chip a medida permite una optimización mucho mayor. SpaceX, Amazon, Meta, Microsoft y Google (esta última con más experiencia gracias a sus TPU) también están siguiendo estrategias similares.
A pesar de estas declaraciones, OpenAI lanzó en agosto de 2025 gpt-oss, sus primeros modelos de código abierto desde GPT-2, diseñados para ejecutarse localmente. El propio Altman admitió en enero de ese año que OpenAI había estado equivocada respecto al código abierto. Cabe destacar que a principios de 2025 la crisis actual de la DRAM no existía. Surge la pregunta de si Altman considera que el segmento de usuarios que utilizan IA local es tan grande y si realmente causa tanto daño a la cadena de suministro, especialmente cuando se observa que la gente no paga por la IA porque lo que se ofrece 'gratuitamente' ya satisface sus necesidades.
Aquellos que poseen una máquina capaz de ejecutar un modelo local saben perfectamente por qué lo hacen; puede ser por necesidades específicas, por la posibilidad de usarlo sin conexión, o simplemente por desconfianza en la seguridad de una empresa como OpenAI.